项目文档
视觉AI助手-眼镜挂件

这是一项基于立创ESP32S3开发板的视觉AI助手
简介
本项目需要自有服务器或长期运行的Linux设备,需要具备有一定的Linux基础操作知识,Docker-Compose知识,Node.JS知识,完全依赖于云端部署,可实现完全免费且自定义极高的AI视觉助手服务,借助Ollama部署框架提供的API接口可自由更换视觉多模态模型,实现低成本的视觉AI功能。
本项目旨在提供了一种AI终端解决方案,诸如最近很火的小智AI,均采用类似技术通过云服务器部署模型,让低性能嵌入式单片机设备以API服务接入服务器取得AI能力。
功能
- ✅支持多模态大模型
- ✅视觉交互
- ✅拍照
- ✅录音
- ✅语音播报
如遇问题,请向我提出issues
服务器部署
除网络环境外,视觉AI多模态语音助手的响应速度完全取决于你的服务器性能
- whisper
- ollama
- llama3.2-vision
- chatTTS
项目参数
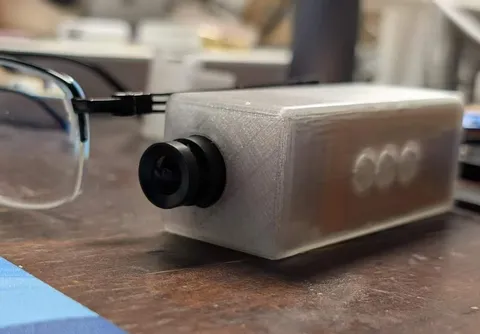
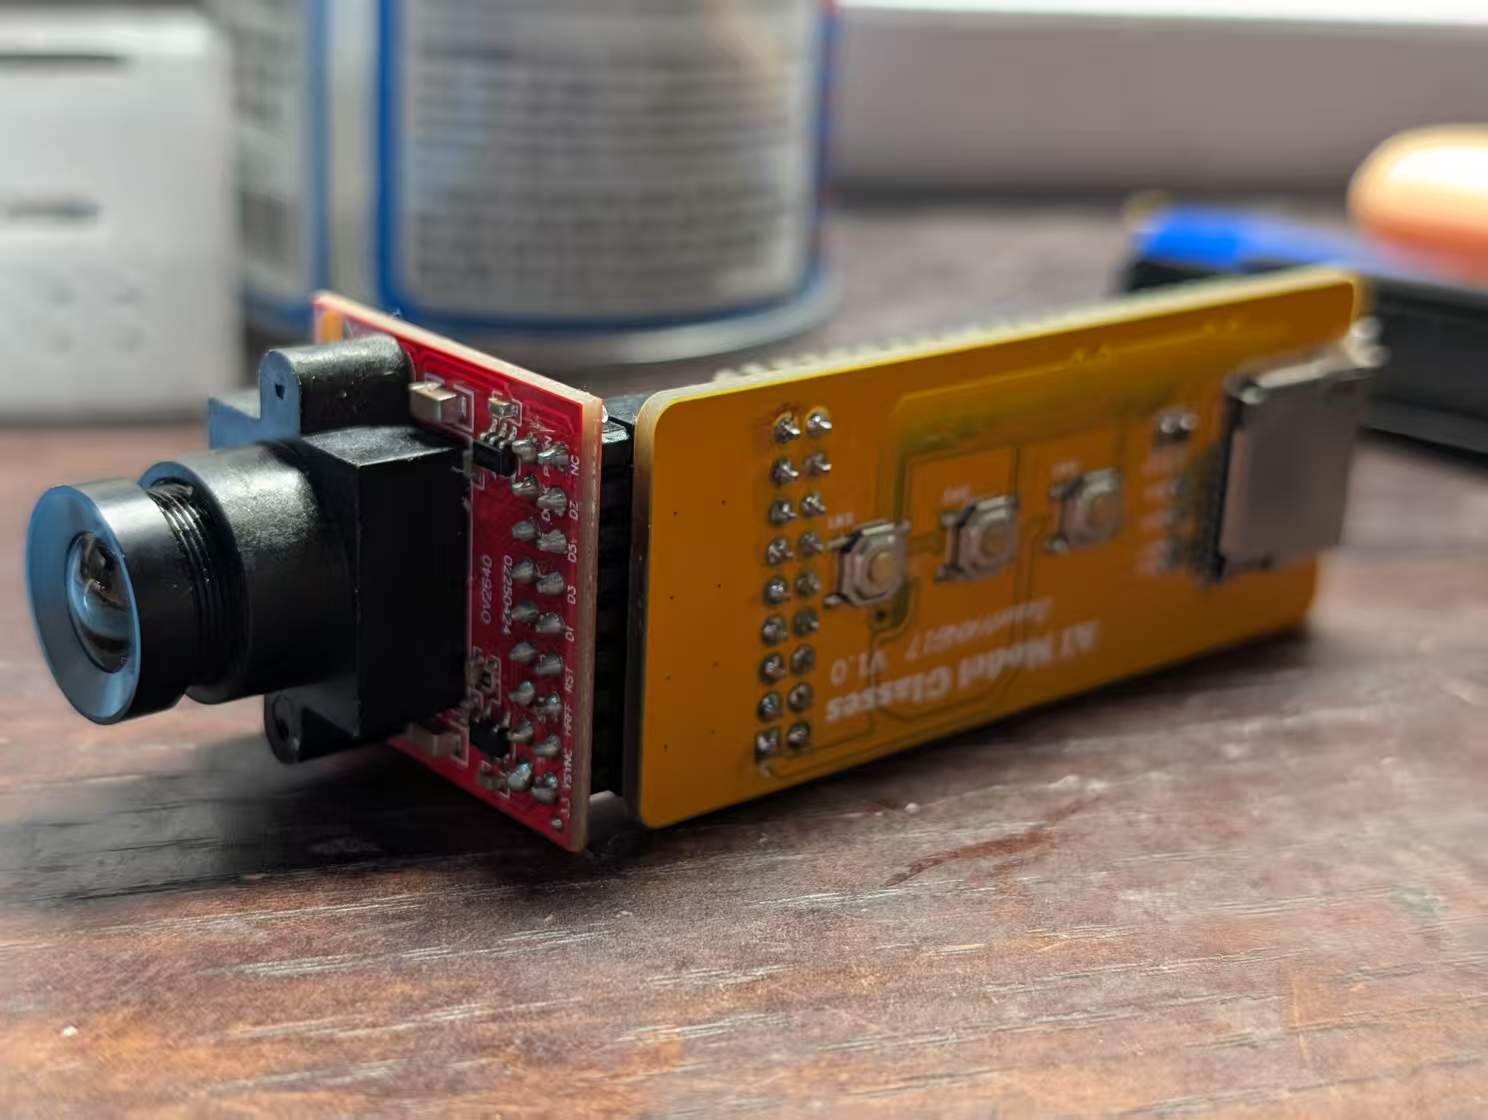
- 本设计采用OV2640摄像头,以实现对环境的视觉采样;
- 本设计采用max98357音频芯片,以实现应答语音播放;
- 本设计采用INMP441全向麦风,以实现环境音频采样;
- 本项目服务使用Docker、Node.js自有服务器搭建
开源协议
本项目遵循CC BY-NC-SA 4.0开源协议,使用本程序时请注明出处并进行版权声明
本项目仅供学习研究,严禁非授权的商业获利,
如果您有更好的建议,欢迎PR
说明
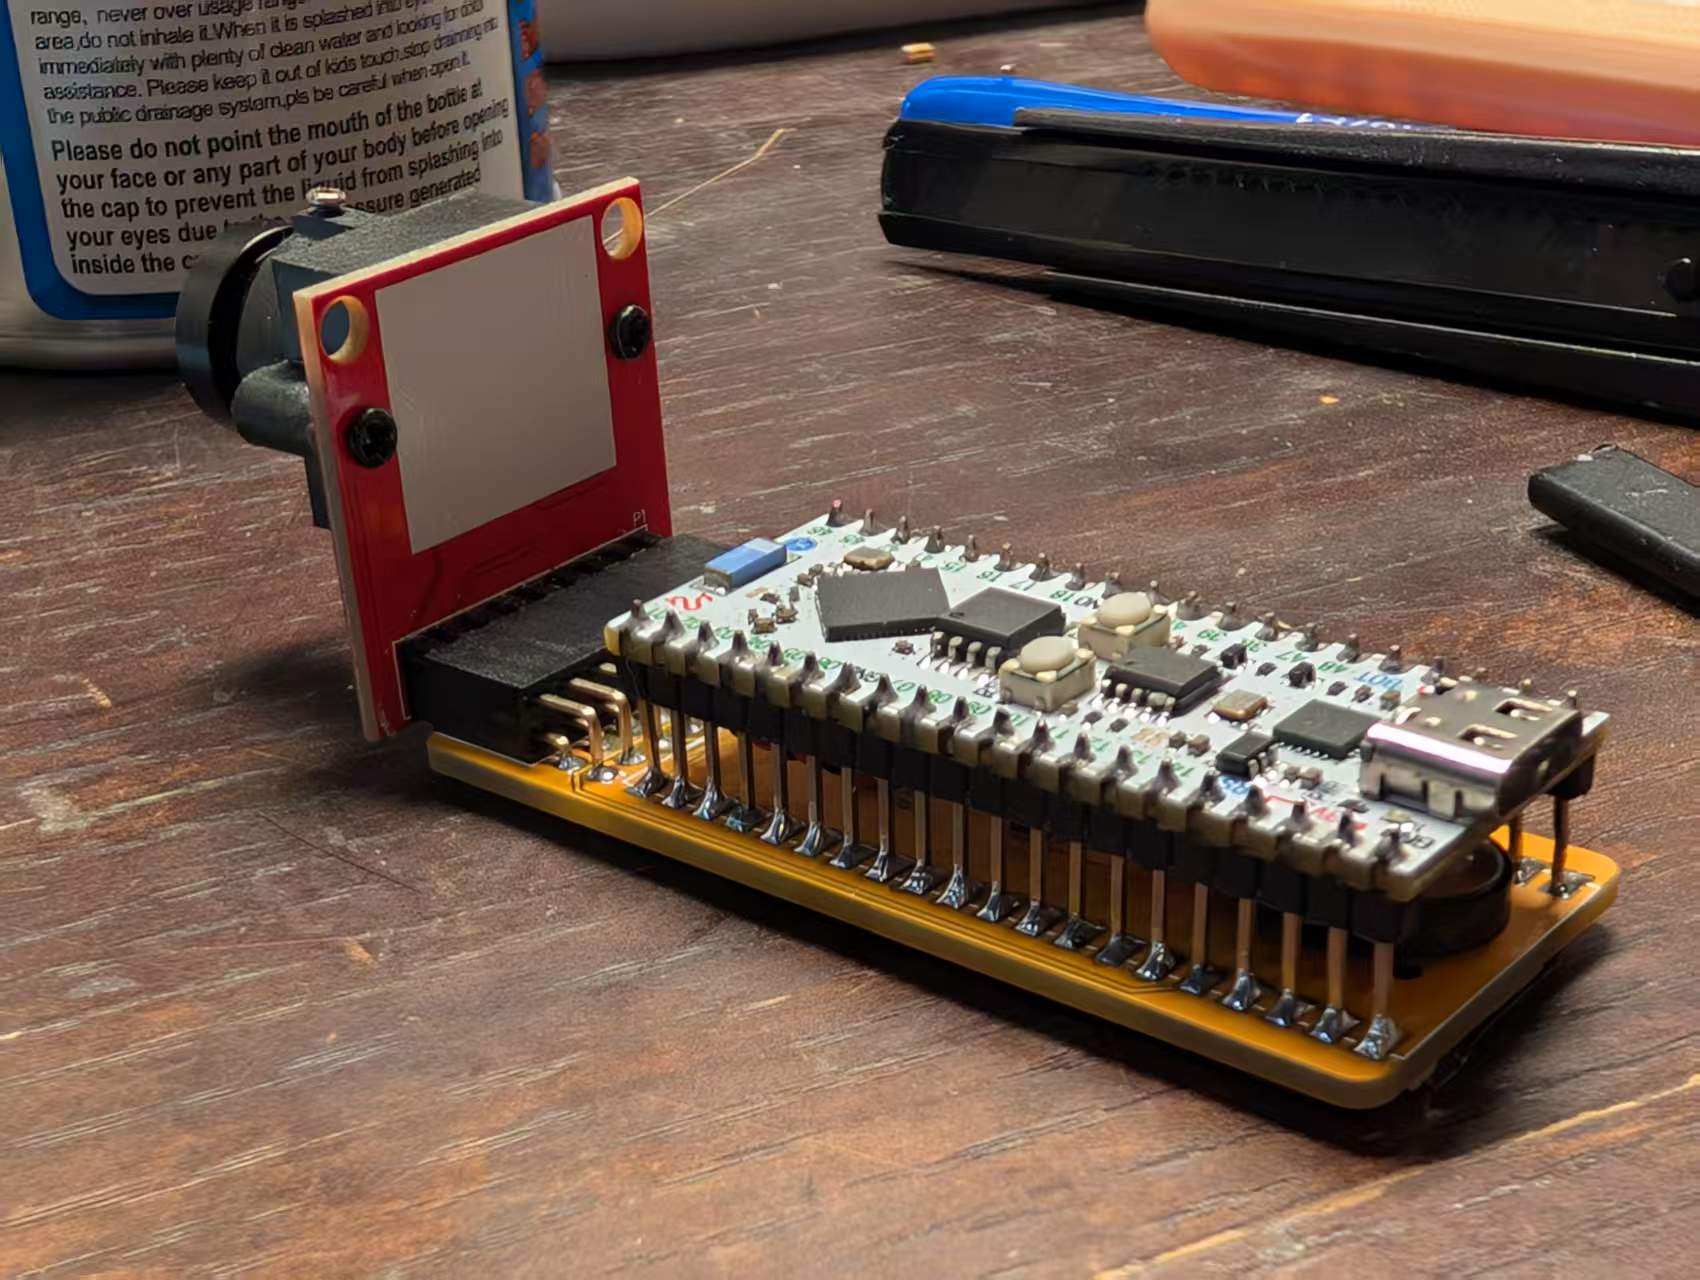
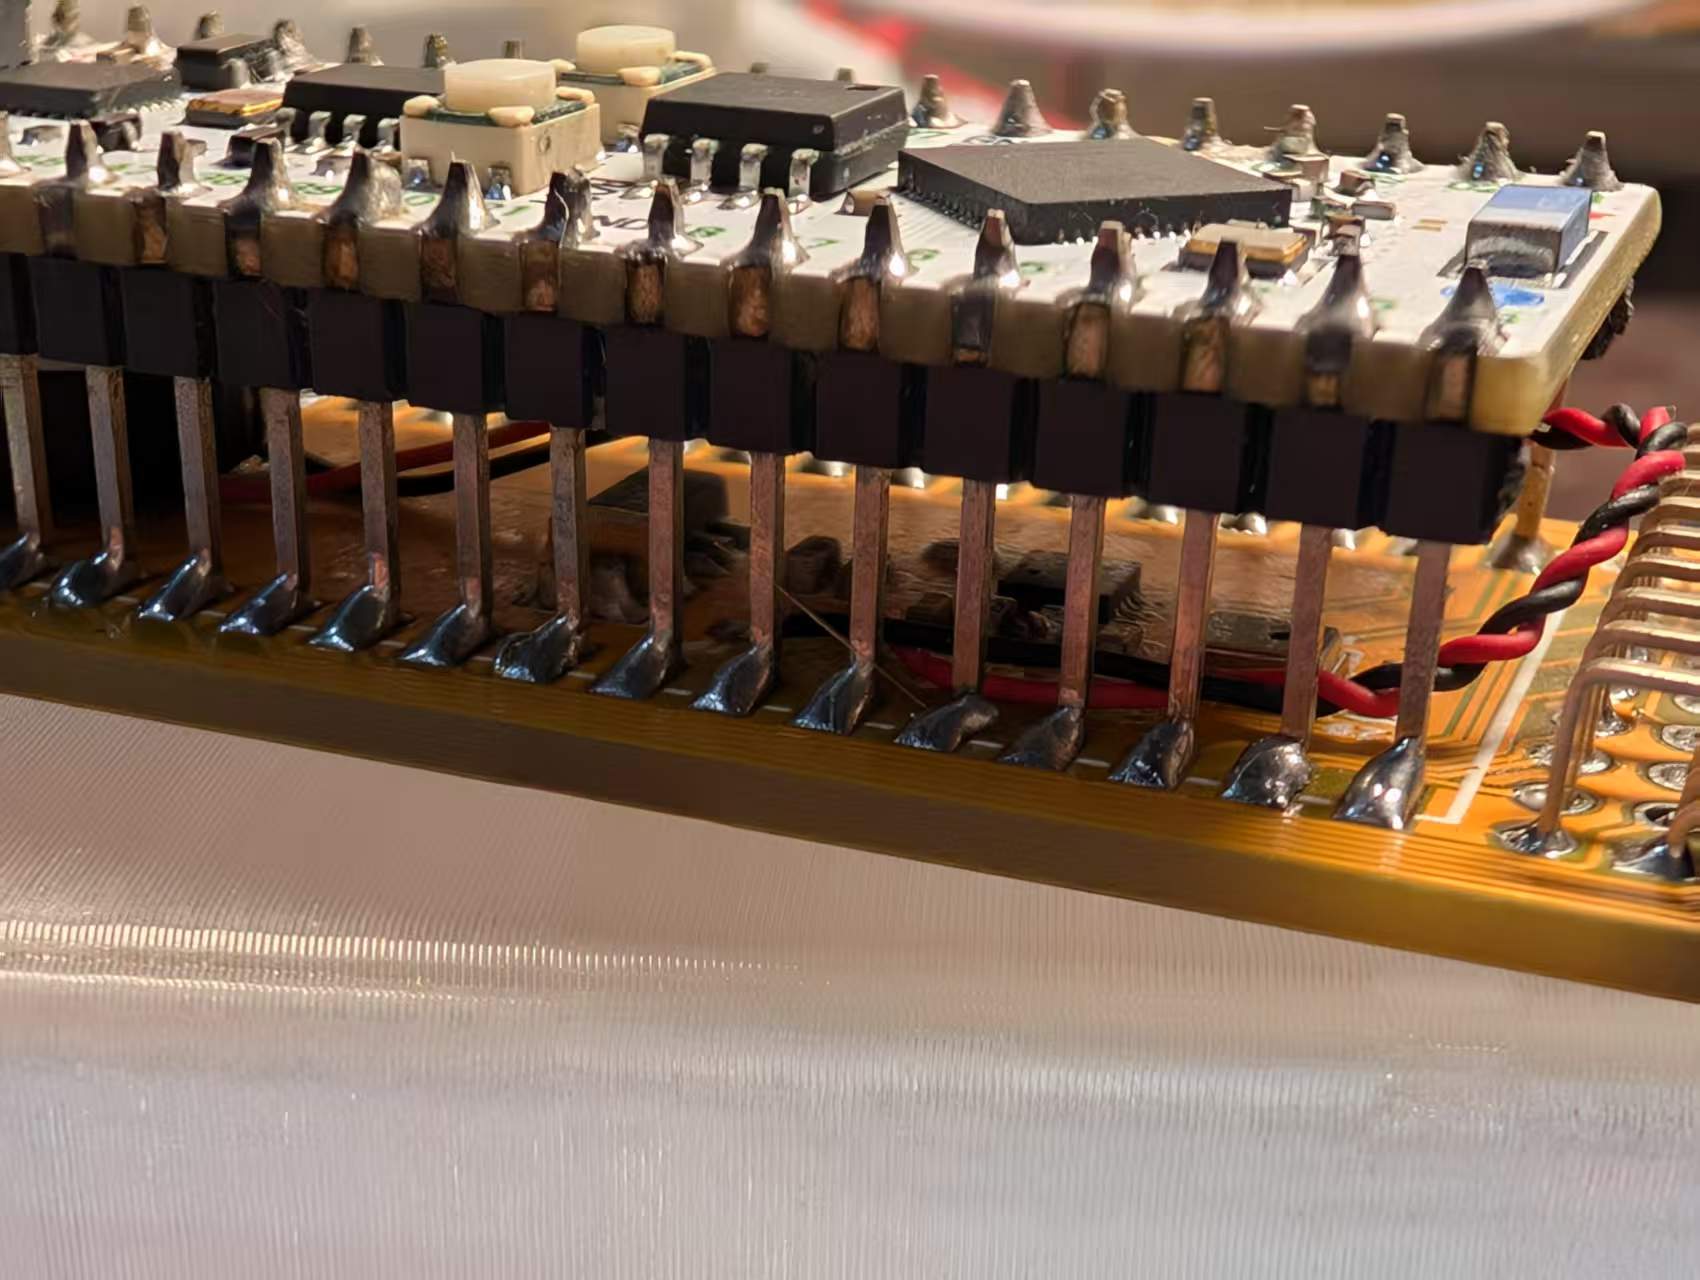
- 空间有限,开发板是通过排针直接焊接在PCB上
- 开发板顶部空间为预留电池位,可装载14500电池
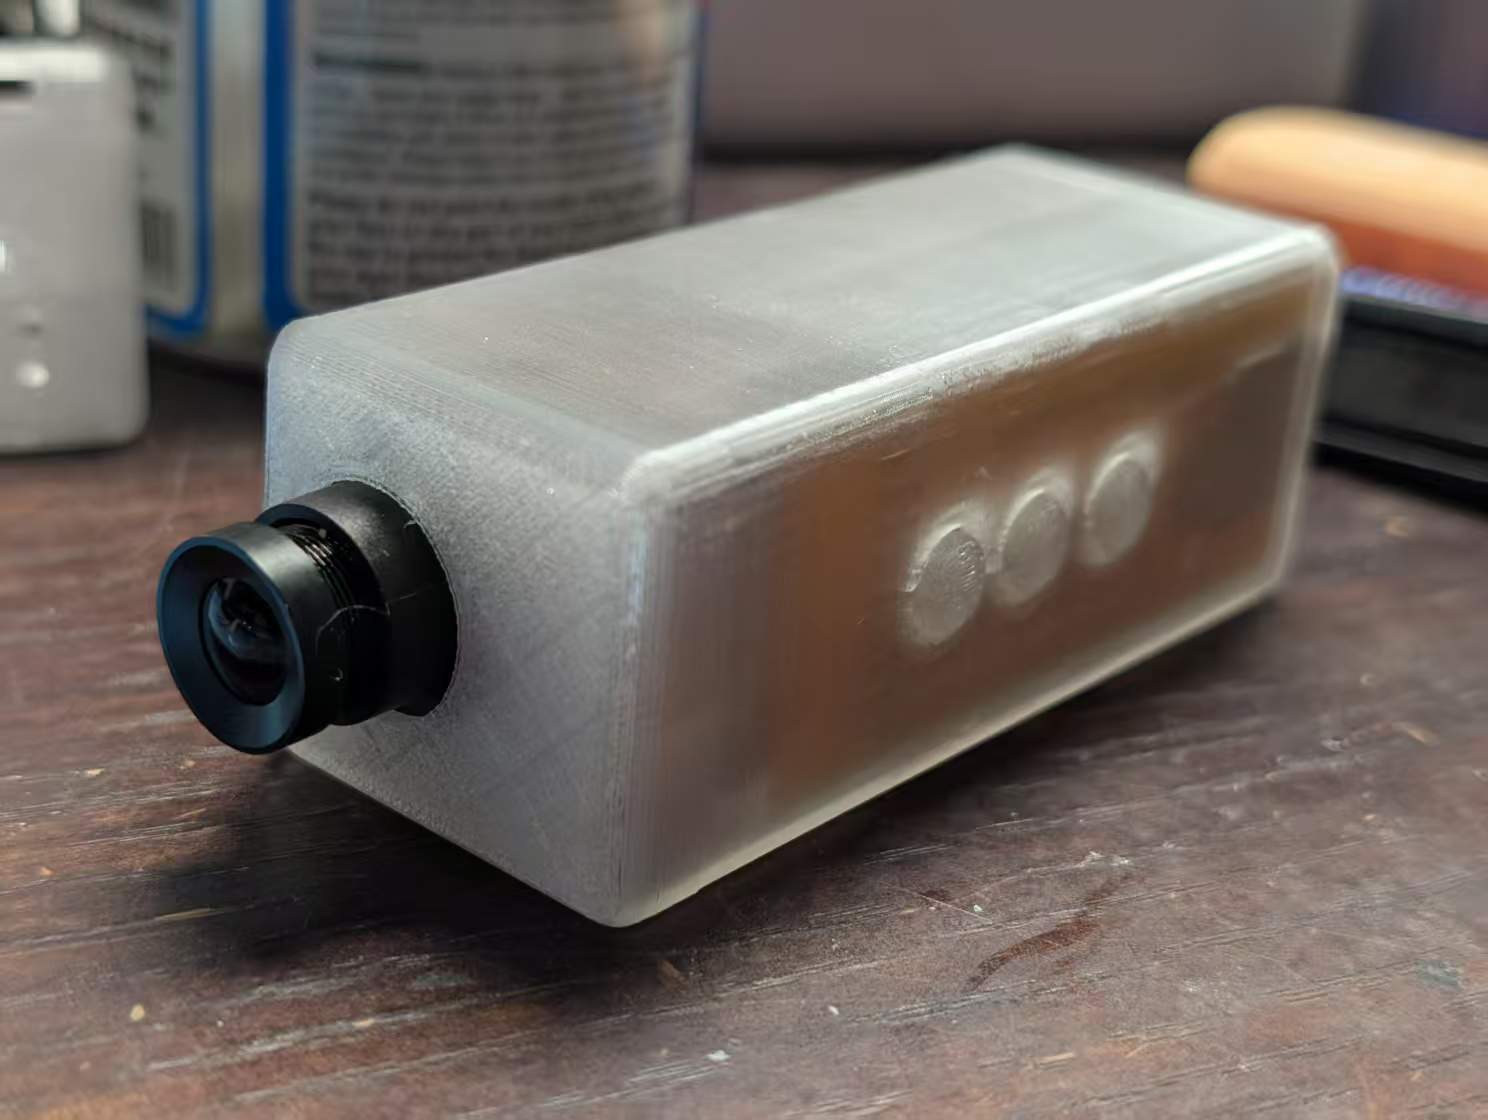
实物图
| 1 | 2 |
|---|---|
 |
 |
 |
 |